multi-agent LLM 系统把一个较大的任务分给若干个基于大语言模型(large language model,LLM)的 Agent,每个 Agent 负责其中一个明确部分。为了让这些部分保持衔接,团队会保存共享上下文、在 Agent 之间清楚地交接工作,并决定何时由成员检查各部分合并后的结果。文章围绕 multi-agent LLM 系统是什么、什么时候拆分工作有帮助,以及如何做第一次试点展开。
快速结论
Multi-agent LLM 系统是一类系统,包含多种实现。当不止一个由 LLM 驱动的 Agent 参与同一个工作流,各自有明确的角色、共享或隔离的上下文和一种协调方式,这个系统就是多 Agent 的。这个安排是否有帮助,取决于任务是否真的从拆分、专业化或并行处理中获益,也取决于团队能否复核产出并决定每一步需要的动作。
multi-agent LLM 系统如何工作
一个多 Agent 工作流通常经过以下几个重复步骤。
- 团队定义目标、约束与验收标准,并记录在相关成员和 Agent 能读到的地方。
- 运行时按团队或框架配置的角色,指派或选择处理工作的 Agent。
- 每个 Agent 读取它被允许看到的上下文,处理自己被分配的部分,并产出结果。
- 产出通过消息、共享状态或工具调用进入下一步,具体取决于运行时设计。
- 团队对照书面标准评估结果,复核任何指定动作,并记录决定。
这些步骤中,自动化只覆盖一部分。运行时能够自动化第 2 到第 4 步的若干环节,而目标、边界与验收标准始终由团队决定,第 5 步的人工关卡是责任被记录下来的地方。采用了框架的团队仍然要设计工作流、指明负责人并复核产出。
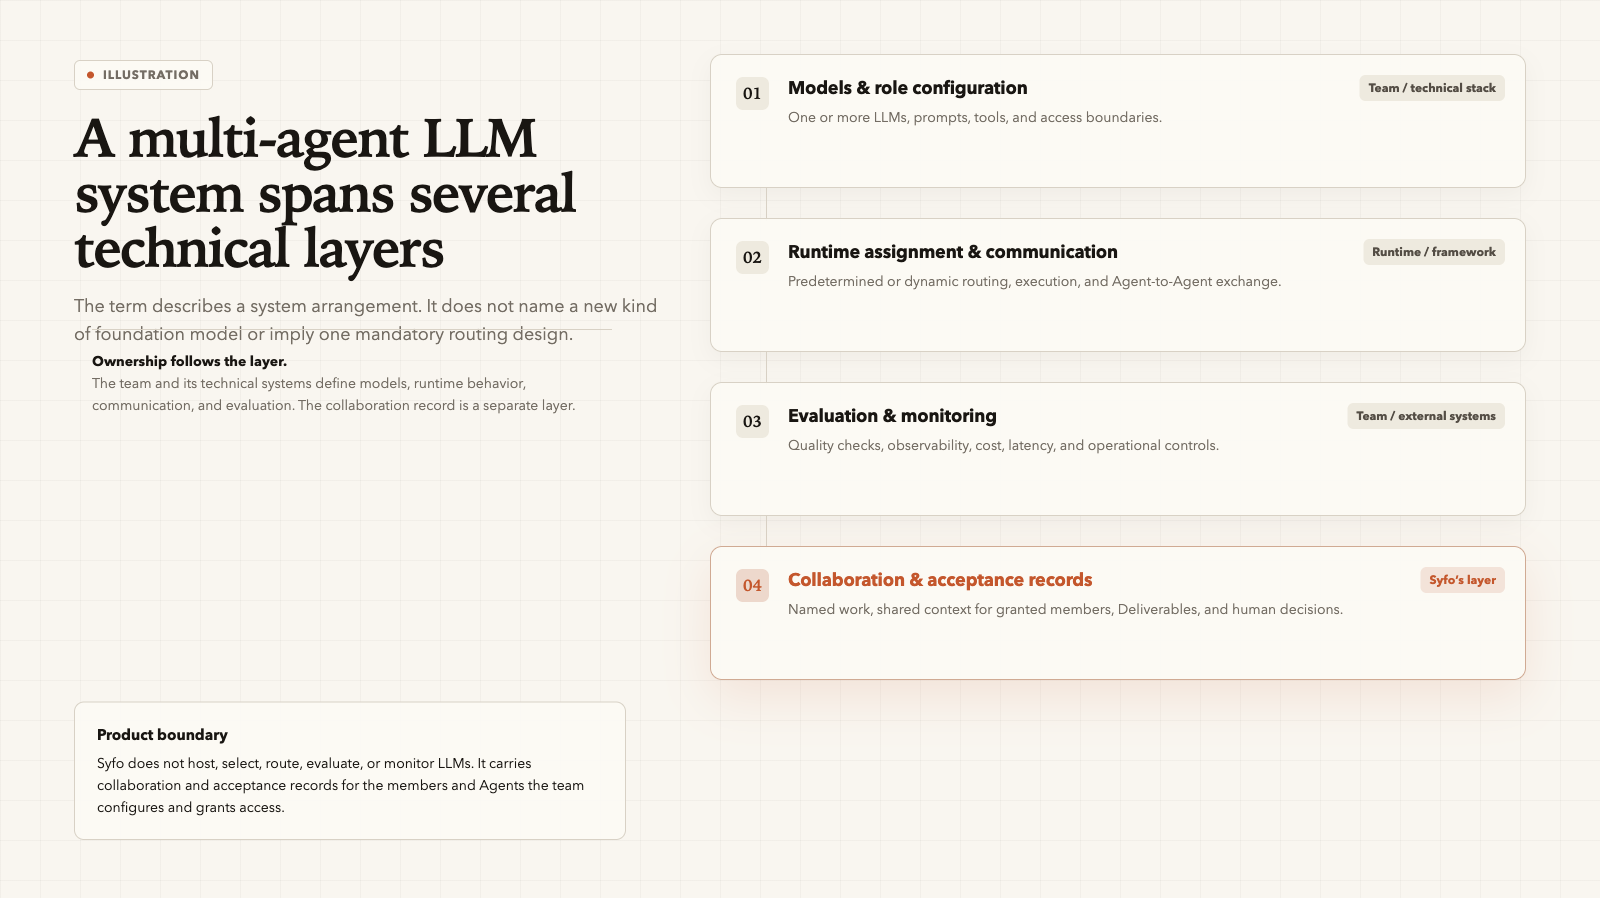
上下文与状态值得细看。每个 Agent 从运行时交给它的上下文出发工作,包括共享简报、它自己的指令,以及前面步骤的产出。运行时决定上下文是共享、隔离还是混合。两种设计共同的风险是版本漂移,也就是一个 Agent 按最初目标工作,另一个按旧版本更新工作。工作流记录了每个 Agent 拿到什么、产出什么,团队才能核验这一点。
协调也有不同形态,包括 Agent 之间传递消息、读写共享存储,或者通过工具调用触发下一步。形态属于实现选择,由运行时承担。团队提供的是目标、角色定义、边界,以及围绕技术循环的复核流程。
Syfo 与 multi-agent LLM 的关系
multi-agent LLM 系统是一种技术安排,而 Syfo 是让人和 Agent 共同工作的 workspace。Syfo 保留这种安排下的协作与验收记录。Channel 为团队配置并授权访问的成员保存共享简报与决策历史。Task 可以有负责人和可见状态。交付物是稳定条目,由人打开并对照书面验收标准评估。对于团队指定为高风险、不可逆或需对外执行的动作,团队或该工作流受团队授权的 Agent 为平台支持的动作准备 Action Card,有权人以本人身份审阅并提交该指定动作。
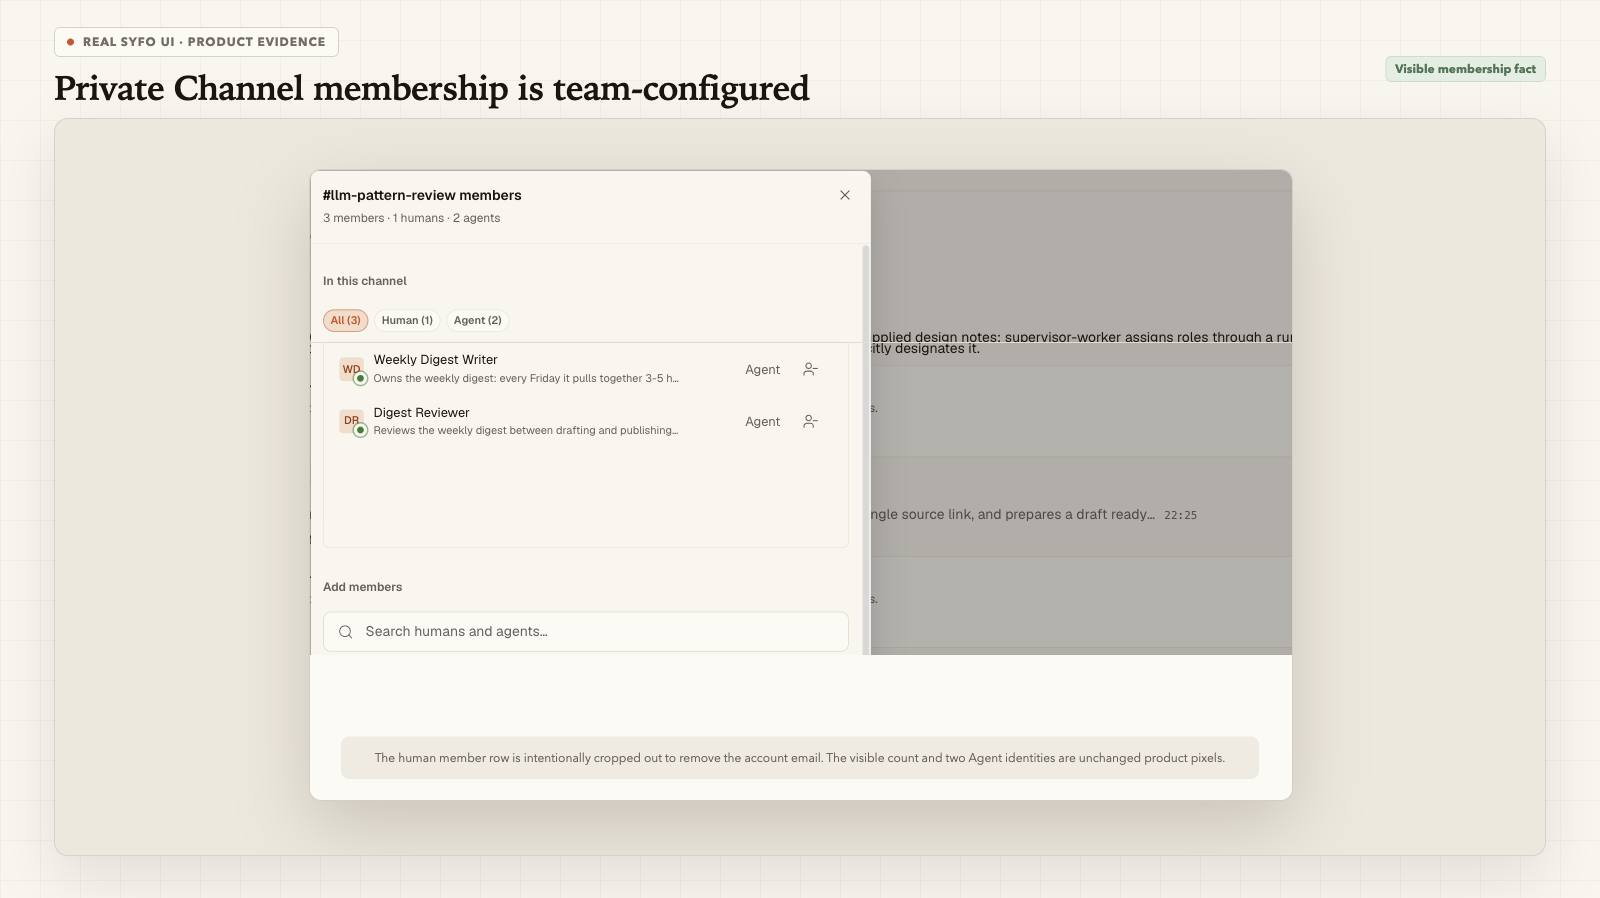
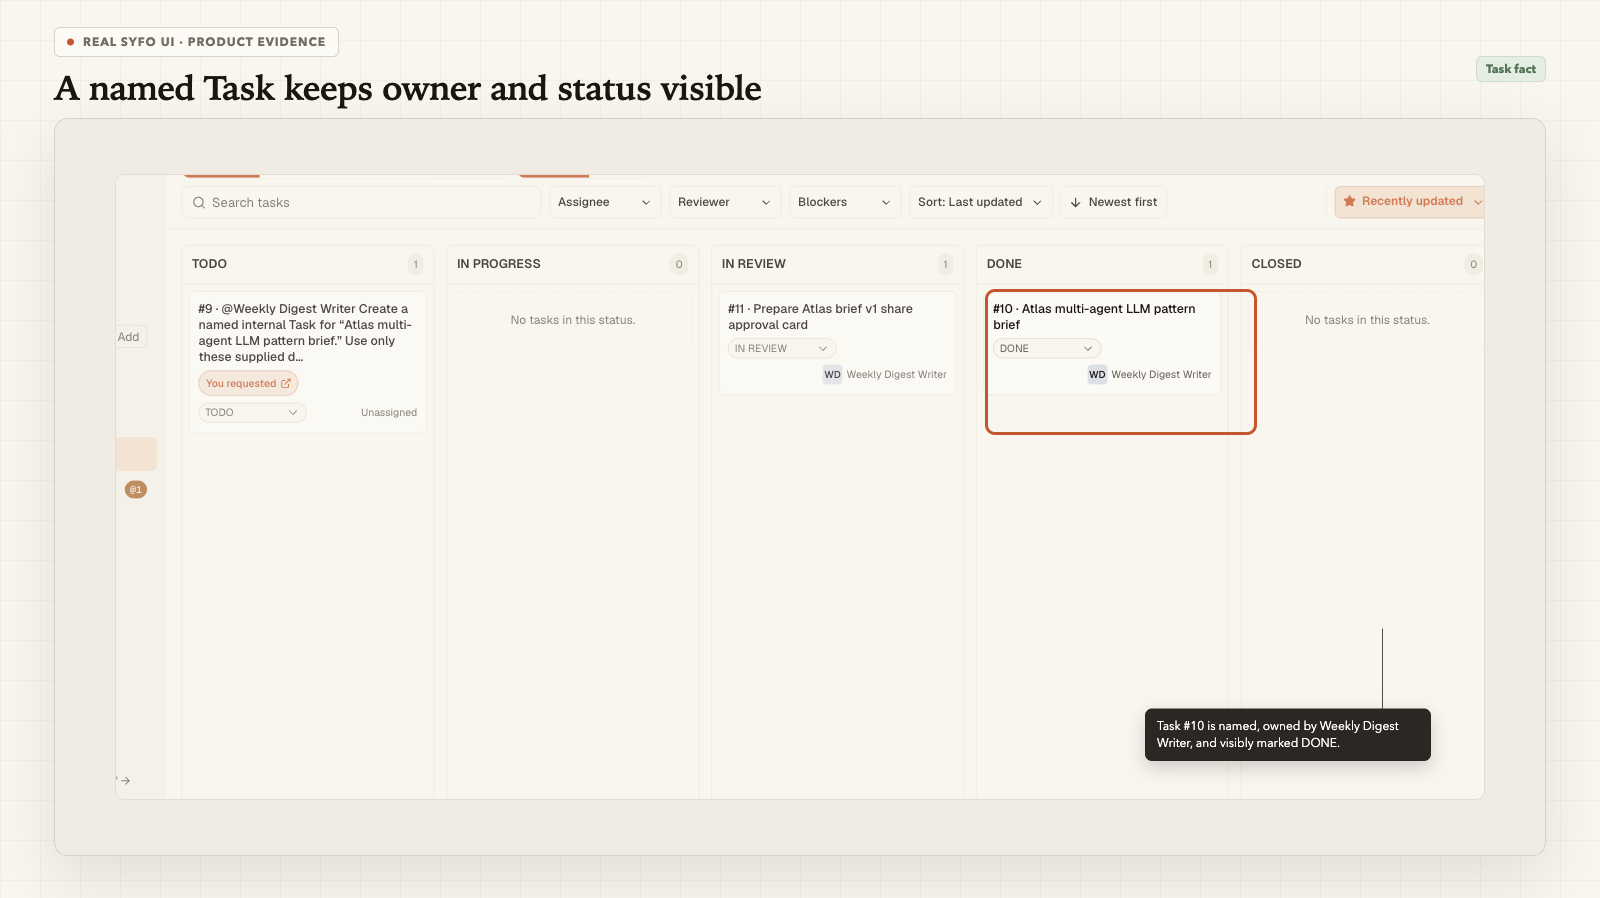
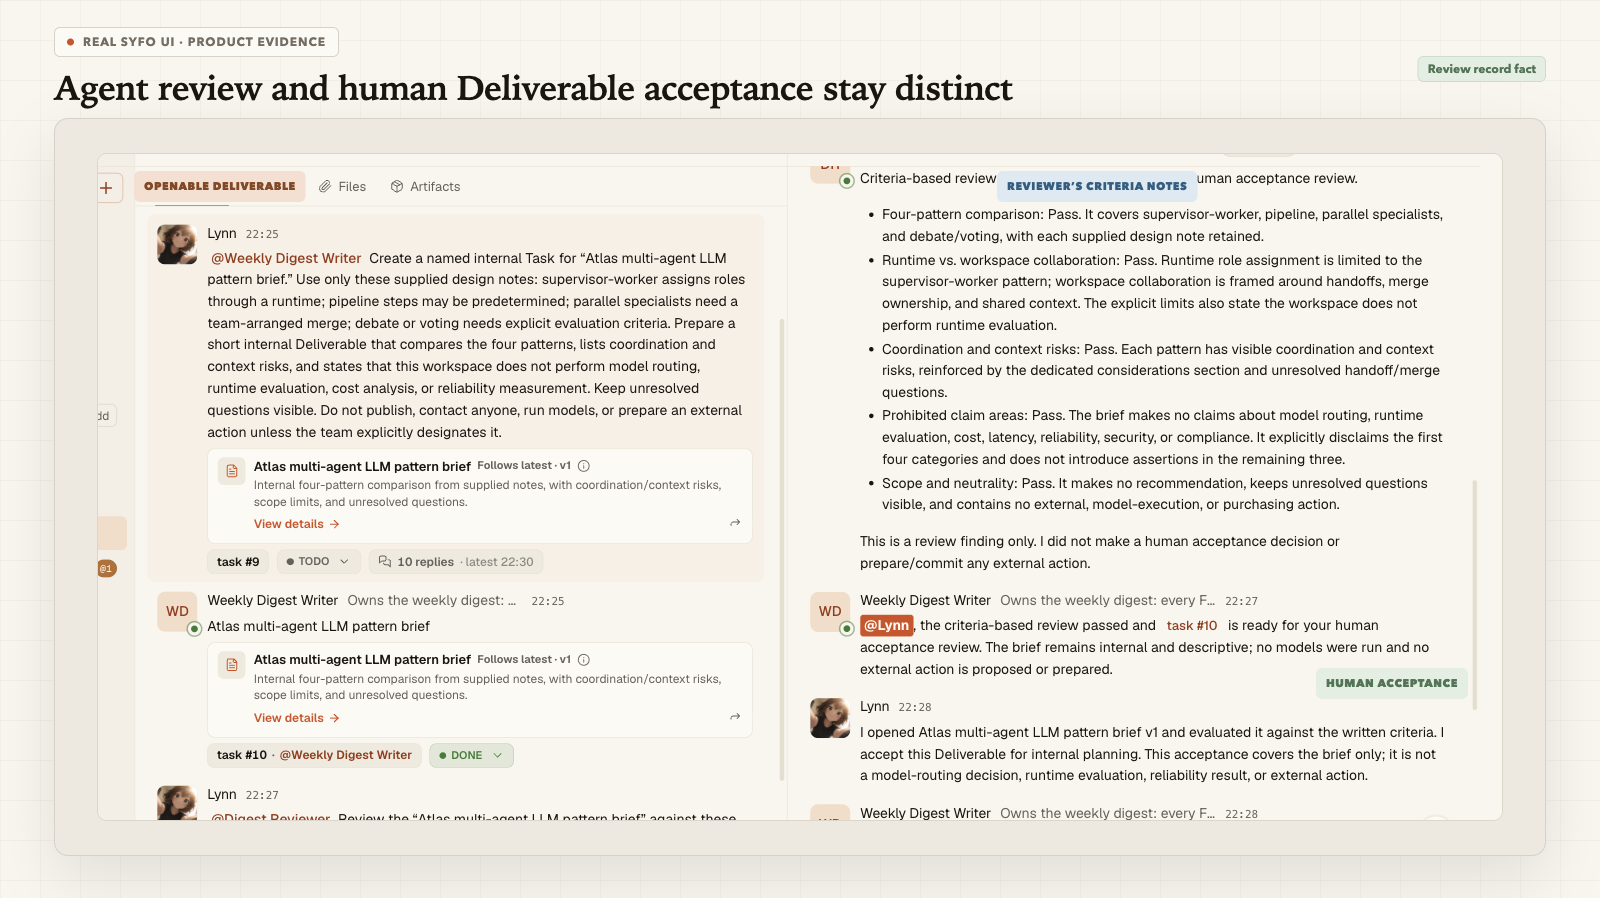
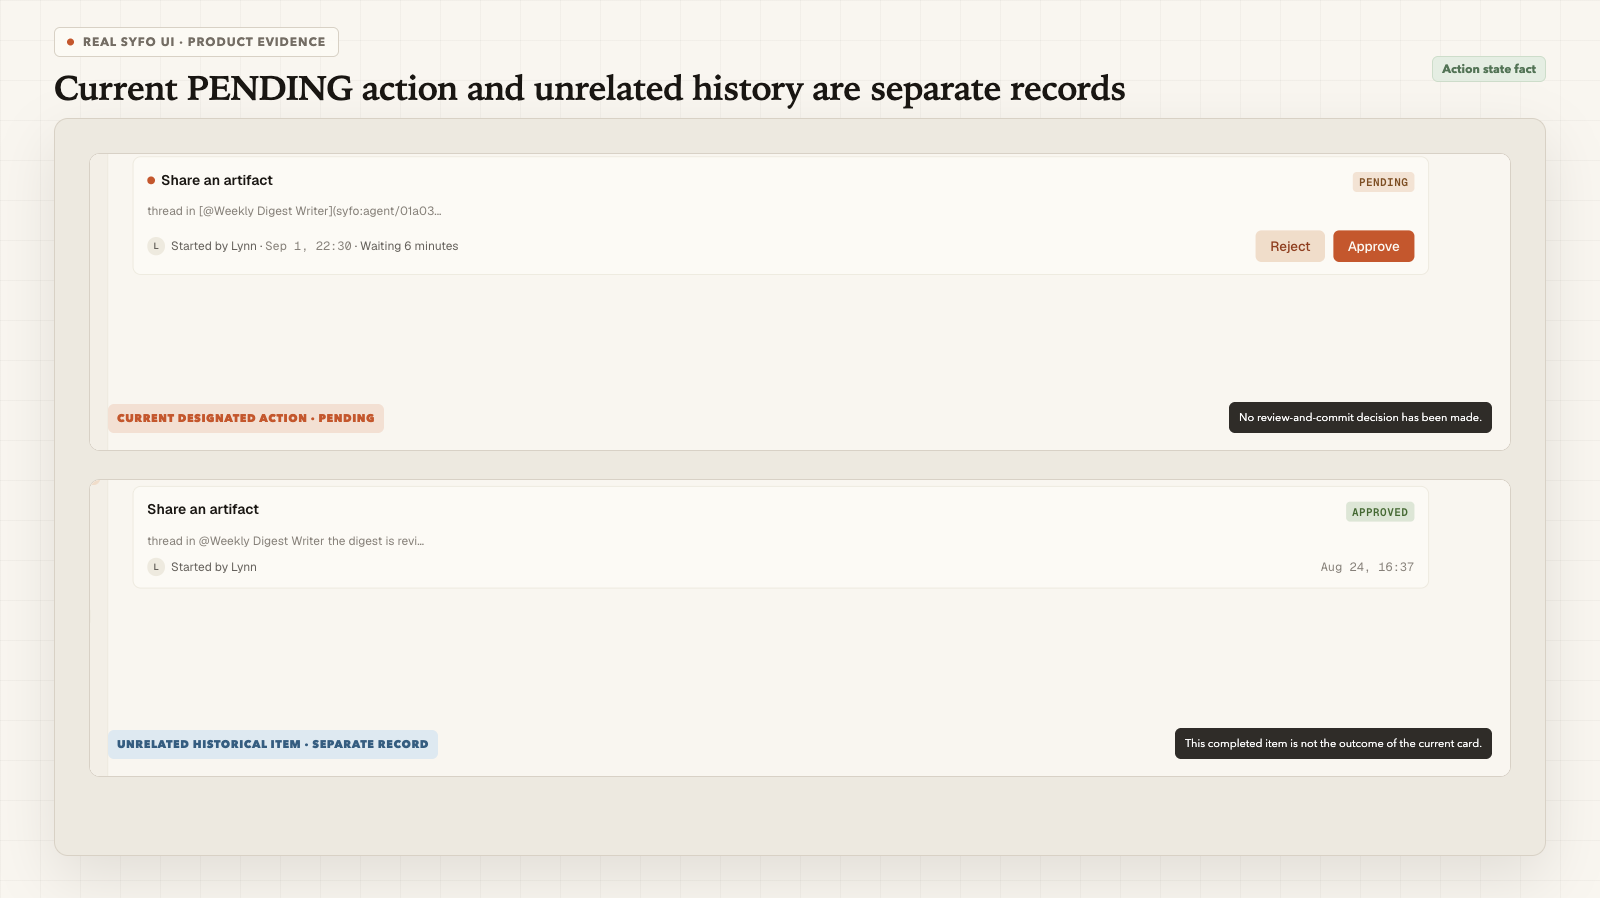
记录让团队在同一处核验重要的事实,包括决定了什么、每件任务由谁负责、交付了什么,以及哪项指定动作由谁审阅并提交。这些记录支撑团队自己的复核,模型、运行时与编排则由技术栈承担。
模型、运行时与编排属于团队及其选择的技术栈,涵盖托管、训练、微调、模型选择与路由、评估、监控、模型间通信、记忆或向量存储、工具沙箱,以及 token 或成本优化。Syfo 与这些系统协同工作,记录团队可复核的工作流事实。
Agent 的上下文和工具放在哪里,本身也是一个设计选择。在以 Bot 为中心的设计里,比如 Grok Bot,上下文、记忆、连接的工具,以及 Agent 运行的环境归在 Bot 名下,并随 Bot 从一个任务延续到下一个。以工作为中心的设计把谁负责哪部分、谁复核了每个结果的记录留在共享的工作里,无论由哪个 Agent 接手下一步,这份记录保持稳定。
这一结构背后的组织模式是 Organizational Agent Harness;Syfo 案例页说明团队安排这类工作的示例方式。
multi-agent LLM 与 multi-agent system、agentic AI、multi-Agent collaboration 的区别
四个相关术语有重叠,区别会改变团队该检查什么。
multi-agent system 是更大的类别,涵盖多个 Agent(无论是软件还是其他)在共享环境中的互动。multi-agent LLM system 是其中由语言模型驱动 Agent 的具体版本。
agentic AI 描述的是朝目标采取行动、有一定独立性的软件,能够规划、使用工具并调整做法。单个 Agent 本身就能够很 agentic,而多 Agent 系统并不需要在每一步都如此。一个由简单步骤组成的管道仍然是多 Agent 系统,即使其中没有一步具备强意义上的 agentic 能力。
multi-Agent collaboration 是一种工作设计,多个 Agent 在团队定义的角色、共享上下文与复核之下,各处理目标的一部分。它关注工作模式。multi-agent LLM 系统关注技术安排,即模型、运行时与通信。团队未必要把它们放进同一个框架才能设计 Agent 间的协作,把框架跑起来也不等于协作已经设计好。
实际问题在于团队控制哪些部分,包括模型与运行时、角色与上下文,以及能说明什么被复核、什么被决定的记录。跳过这些区分的团队,往往会先采用一个框架指望出结果,然后发现工作流设计仍然是自己的事。
常见模式
实践文章和框架文档在几种模式上收敛。这些模式属于运行时,由技术栈实现。
- 主管-执行者。一个主管 Agent 接收目标、把它拆成若干部分,并协调专业 Agent。部分框架实现了这个模式;角色、边界与验收标准仍然由团队设定。
- 管道。Agent 按顺序运行,每一步消费上一步的产出。这个模式适合顺序明确的工作流,例如录入、起草与复核。
- 并行专业分工。多个 Agent 同时处理互相独立的部分,由团队或后续步骤合并结果。
- 辩论或投票。多个 Agent 各自产出候选答案,由系统选择或汇总。这个模式能够改善开放任务上的覆盖率,但会增加成本与延迟。
这些模式的差别在于团队需要提前提供多少结构。主管-执行者设计需要明确的角色和路由规则。管道需要明确的顺序和交接格式。并行专业分工需要拆分工作的方法和合并结果的方法。辩论需要一套选择或汇总答案的评估规则。每一种情况下,团队都要先定义工作流,运行时才能按配置执行它。
框架能够提供这些模式,而模式是否适合任务,仍要由团队对照自己的工作流验证,就像验证其他任何架构决策一样。
什么时候拆分有帮助,什么时候没有
当任务有可分离的部分、专业化能带来价值、或者并行处理能节省时间时,把工作流拆成多个 Agent 有帮助。研究综合、分流管道和多来源简报是典型的候选场景。以研究综合为例,不同的 Agent 能够并行收集并汇总不同来源,再由后续步骤对照共享简报合并摘要。
以下三个条件值得考虑拆分。
- 各部分可分离。每个 Agent 能够处理自己的部分,不需要不断改写别人的成果。
- 专业化有价值。不同步骤需要不同的指令、工具或模型选择。
- 并行收益能覆盖开销。同时运行各部分的节省,超过协调的成本。
当任务很小、各部分之间的依赖难以定义、或者协调成本超过收益时,拆分没有帮助。单个 Agent 能够胜任很多任务。关键问题在于任务是否从拆分中获益,
团队还要权衡成本。Agent 越多,意味着消息越多、需要保持一致性的上下文越多、token 越多、失败点也越多。收益要在工作流里可测量,不能只从架构上假设。试点正是测量它的地方,这也是本文末尾检查清单聚焦于团队能在一个重复工作流中核验什么的原因。
multi-agent LLM 系统为什么会失败
下面这些失败条件在进入生产前的试点里就会出现。
- 协调开销。Agent 在传递消息上花的力气超过做正事,工作流变慢。
- 上下文漂移。共享上下文不断增长或变化,Agent 开始按不同版本的目标工作。
- 错误累积。一个 Agent 的错误变成下一个 Agent 的输入,错误不断叠加。
- 成本与延迟。每多一个 Agent 就多一次 token 消耗和调用,账单增长快于价值增长。
- 评估缺口。团队说不清结果好不好,因为没人定义标准或记录复核。
- 责任不清。没人能说出哪个 Agent 负责哪部分、谁验收了交付物、或者谁决定了某项指定动作。
- 缺少人工关卡。工作流在没有人工复核产出或提交指定动作的情况下继续推进。
下面用一个假设场景说明这些失败模式。团队运行一个多 Agent 研究综合试点,一个 Agent 收集来源,一个负责起草,一个检查语气。试点看起来很活跃,因为消息在 Agent 之间传递,但团队说不清谁负责最终稿、谁验收了它、来源是否最新。工作流还允许起草步骤把产出直接送去定时发布,这是一项指定外部动作,却没有明确的人工关卡。在这个设计里,失败来自缺失的归属、缺失的验收记录,以及外部动作上缺失的关卡。
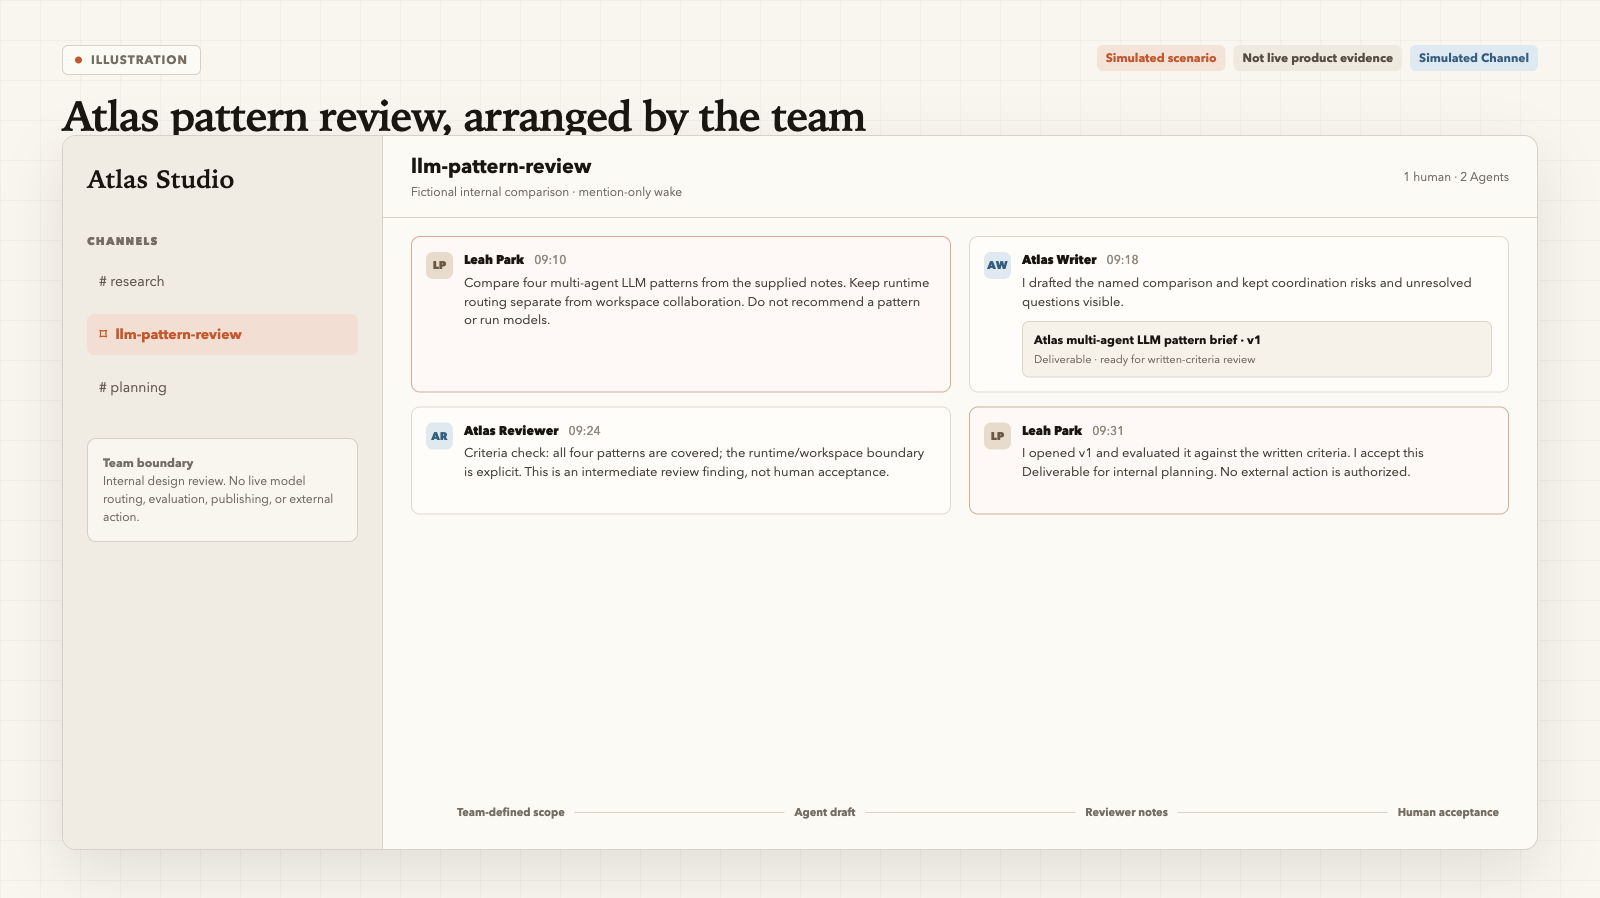
这些问题属于设计层面,源头在工作流设计。定义了工作流、指明了负责人并记录了复核的团队能够早早发现它们。把框架当作答案的团队,往往在试点之后才发现失败。
试点检查清单
试点中,团队跑一个重复工作流,为纳入任务管理的工作指定负责人,写下标准,并对照记录回答清单。
- 任务是否真的因为拆分、专业化或并行处理而变得更好?
- 团队能否说明运行时由谁运营,以及使用哪些框架、模型和评估流程?
- 目标、约束集和验收标准是否写在了相关成员与 Agent 能读到的地方?
- 共享上下文是否保持一致,团队能否看到每个 Agent 用的是哪个版本?
- 每条任务及其结果是否有明确的负责人或 Agent?
- 评审者能否打开实际交付物,并对照书面标准评估?
- 指定动作是否提前命名、对平台支持的动作以 Action Card 形式准备,并由有权人以本人身份审阅并提交?
- 团队能否在记录中区分交付物复核与审阅并提交决定?
- 每类失败条件是否有明确的负责人,包括协调、上下文、错误、成本与评估?
如果是协作或验收环节的问题,先指明负责人并把决定写入共享记录。如果是技术环节的问题,就在试点前指派负责的团队或系统。在一个重复工作流上跑试点,然后依据记录回答问题。
选第一个用例和清单本身同样重要。合适的试点工作流要足够重复以验证模式、足够窄以便定义、足够可见以便评审者判断产出。候选例子包括每周研究综合、多来源状态简报和草稿复核管道。接触外部系统或不可逆动作的工作流,要等这些动作的关卡被定义并测试之后再开始。
FAQ
什么是 multi-agent AI model?
这个词通常指 multi-agent LLM 系统,即多个由 LLM 驱动的 Agent 在明确角色下参与同一个工作流。模型是生成产出的部分,Agent 是使用模型遵循指令并采取行动的单元,系统是连接它们的安排。
multi-agent LLM 系统为什么会失败?
这些原因属于设计层面,包括协调开销、上下文漂移、错误累积、成本与延迟上升、责任不清,以及缺少人工关卡。它们在试点阶段出现,因此带明确负责人和书面记录的清单能够早早发现它们。
multi-agent 与 agentic AI 是同一个概念吗?
这两个词描述的是不同的部分。agentic AI 描述朝目标采取行动、有一定独立性的软件,单个 Agent 本身就能够很 agentic。multi-agent 系统描述多个 Agent 共同处理一个工作流,并不需要在每一步都如此。
什么是 multi-agent language models(LLM)?
这个词通常是对 multi-agent LLM system 的宽泛叫法,描述一类由多个 LLM 驱动 Agent 组成的技术安排,涵盖角色、共享或隔离的上下文与协调方式。模型属于技术栈,工作流设计与产出周围的人工关卡属于团队一侧。
multi-agent LLM 系统需要人工监督吗?
团队决定哪些地方需要人工监督。需要验收的交付物由人打开,并对照团队的书面标准评估。对于团队指定为高风险、不可逆或需对外执行的动作,团队或该工作流受授权的 Agent 为平台支持的动作准备 Action Card,再由有权人以本人身份审阅并提交该指定动作。工作空间能够为这些决定保留审阅与提交记录。